꼭 알아야 할 생성형 AI의 세 가지 작동 원리
하루가 다르게 발전하는 AI를 보고 있으면 대체 어디까지 똑똑해질 작정인가 싶다. 수많은 분야의 지식을 막힘없이 설명하고, 처음 보는 문제까지 풀어내는 걸 보면 문득 그 답이 어디서 어떻게 나오는지 궁금해진다. 대규모 언어 모델(LLM)의 작동 방식을 설명하는 논문과 책은 많지만 비전문가 입장에서는 좀처럼 이해하기 쉽지 않다. 하지만 AI가 답변을 만들어내는 큰 흐름을 이해하는 데는 파라미터, 추론, 웹 검색 세 가지 개념 정도만 알아둬도 충분하다.
1. 파라미터: 학습한 지식을 담는 방식
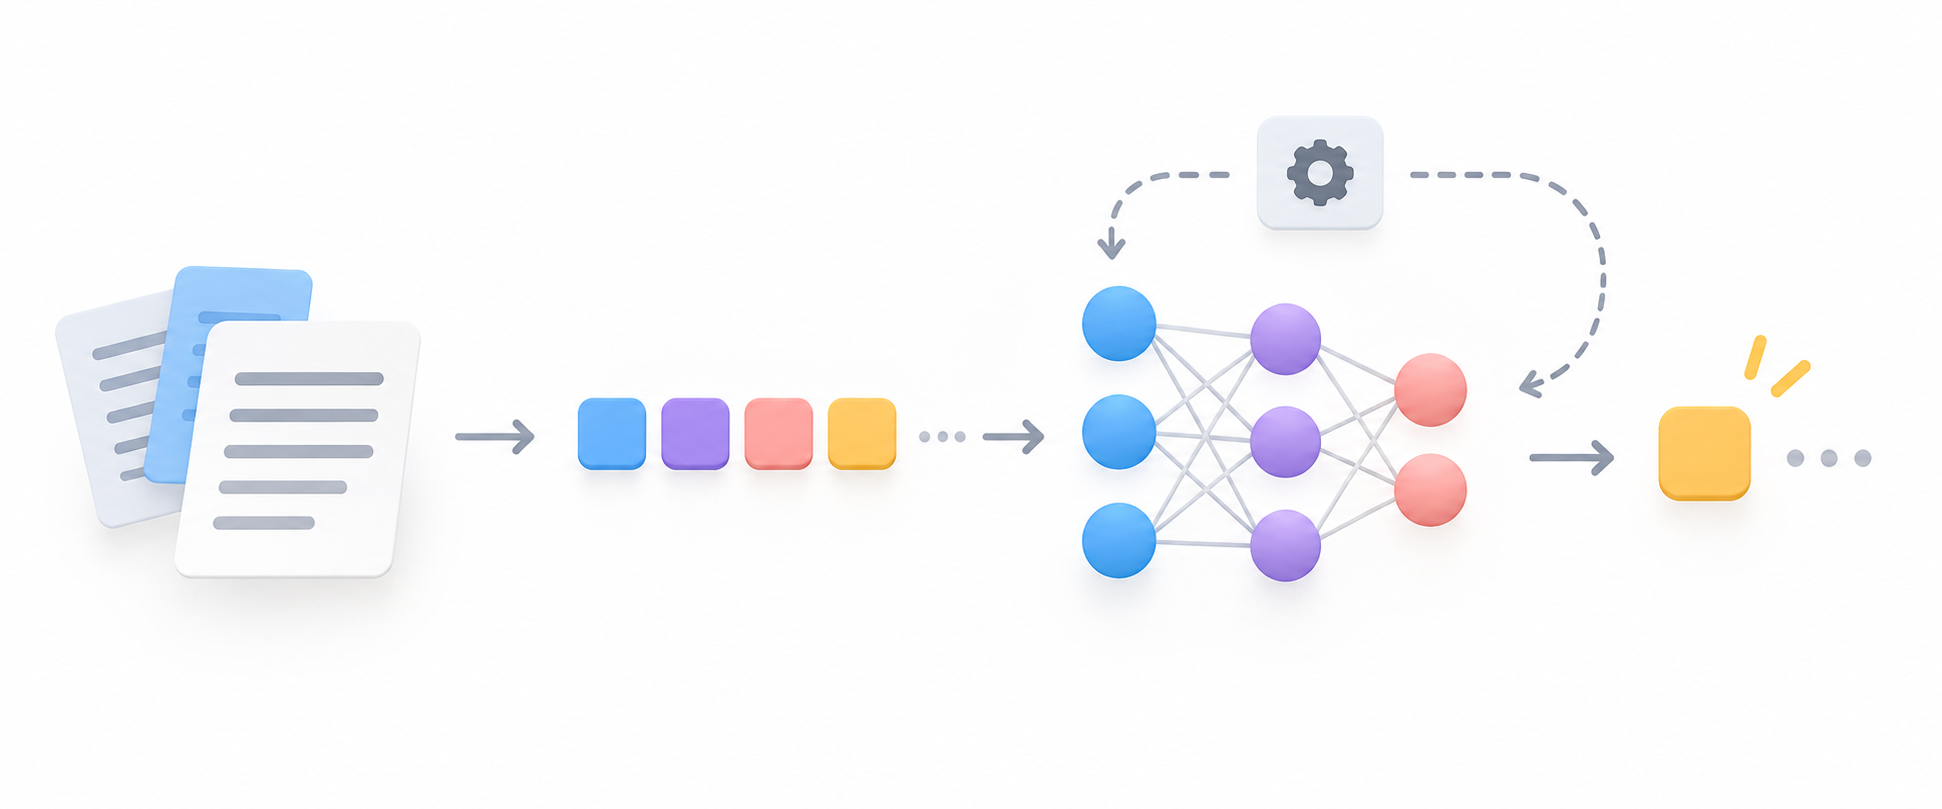
대규모 언어 모델은 방대한 학습 데이터를 바탕으로 언어와 지식의 패턴을 학습한 수학적 모델이라고 할 수 있다. 이렇게 학습한 패턴은 파라미터(parameter, 매개변수)라는 수치에 반영되며, 파라미터는 대부분 가중치(weight)로 구성되어 있다. 즉, 파라미터는 모델이 학습 과정에서 익힌 패턴을 숫자로 표현한 값이다.
모델이 패턴을 익힐 땐 먼저 텍스트를 토큰(token)이라는 작은 단위로 나눈다. 토큰은 단어 하나일 수도 있고 단어의 일부일 수도 있다. 모델은 수많은 텍스트를 학습하면서 다음에 어떤 토큰이 등장할 확률이 높은지 예측하고, 예측이 실제 데이터와 가까워지도록 내부 파라미터를 반복해서 조정한다. 이 과정이 바로 '학습'이다.
이런 학습을 위해 대규모 언어 모델은 매우 많은 수의 파라미터를 사용하는데, GLM-5.3 모델에는 무려 7,440억 개의 파라미터가 있다. 모델은 이처럼 방대한 파라미터의 값을 조정하면서 언어와 지식에 존재하는 복잡한 패턴을 익힌다. 학습이 끝난 모델에 질문을 던지면, 파라미터와 현재 문맥을 바탕으로 다음에 올 가능성이 높은 토큰을 하나씩 예측하며 답변을 생성한다.
이렇게 보면 대규모 언어 모델의 작동 방식은 방대한 지식의 '압축과 생성'인 셈이다. 학습 데이터에서 발견한 패턴을 파라미터에 압축해 두었다가, 질문을 받으면 그 패턴을 바탕으로 새로운 문장을 만들어내는 것이다.
2. 추론: 알고 있는 정보로 답을 구하는 방식
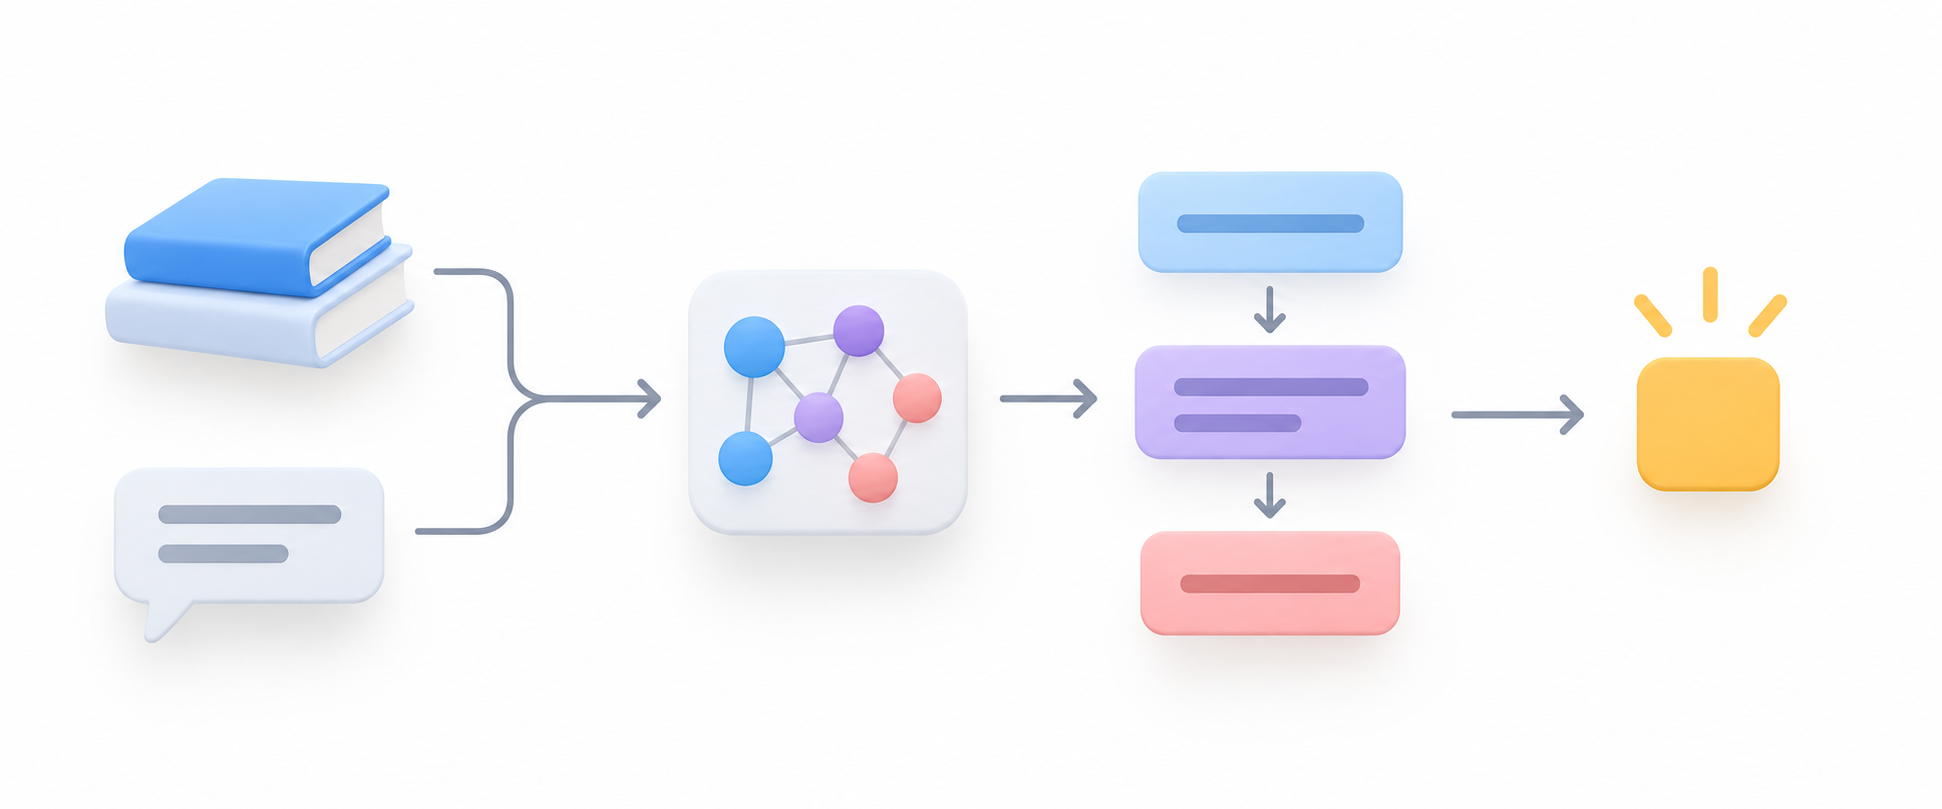
일반적으로 충분한 데이터와 적절한 학습이 뒷받침된다면 파라미터가 많을수록 더 복잡한 패턴을 표현할 수 있다. 하지만 모델이 커질수록 학습과 운영에 필요한 컴퓨팅 자원과 비용 역시 급증하므로 무작정 파라미터를 늘릴 수는 없는 노릇이다.
게다가 모든 정보를 파라미터에 직접 담아둘 필요도 없다. 이미 알고 있는 정보를 이용하면 추론해서 알아낼 수 있는 것도 많기 때문이다.
예를 들어 어느 도시의 출생률과 사망률을 알고 있다면 계산(출생률−사망률)을 통해 인구의 자연증가율을 구할 수 있다. 결과 자체를 미리 외우지 않아도 주어진 정보로 답을 도출할 수 있는 것이다.
이 원리는 대규모 언어 모델에 그대로 적용된다. 학습을 통해 익힌 지식과 질문의 정보를 조합하고 단계적으로 추론함으로써, 학습 데이터에는 존재하지 않았던 문제도 어느 정도 풀어낼 수 있다.
3. 웹 검색: 외부에서 정보를 찾는 방식
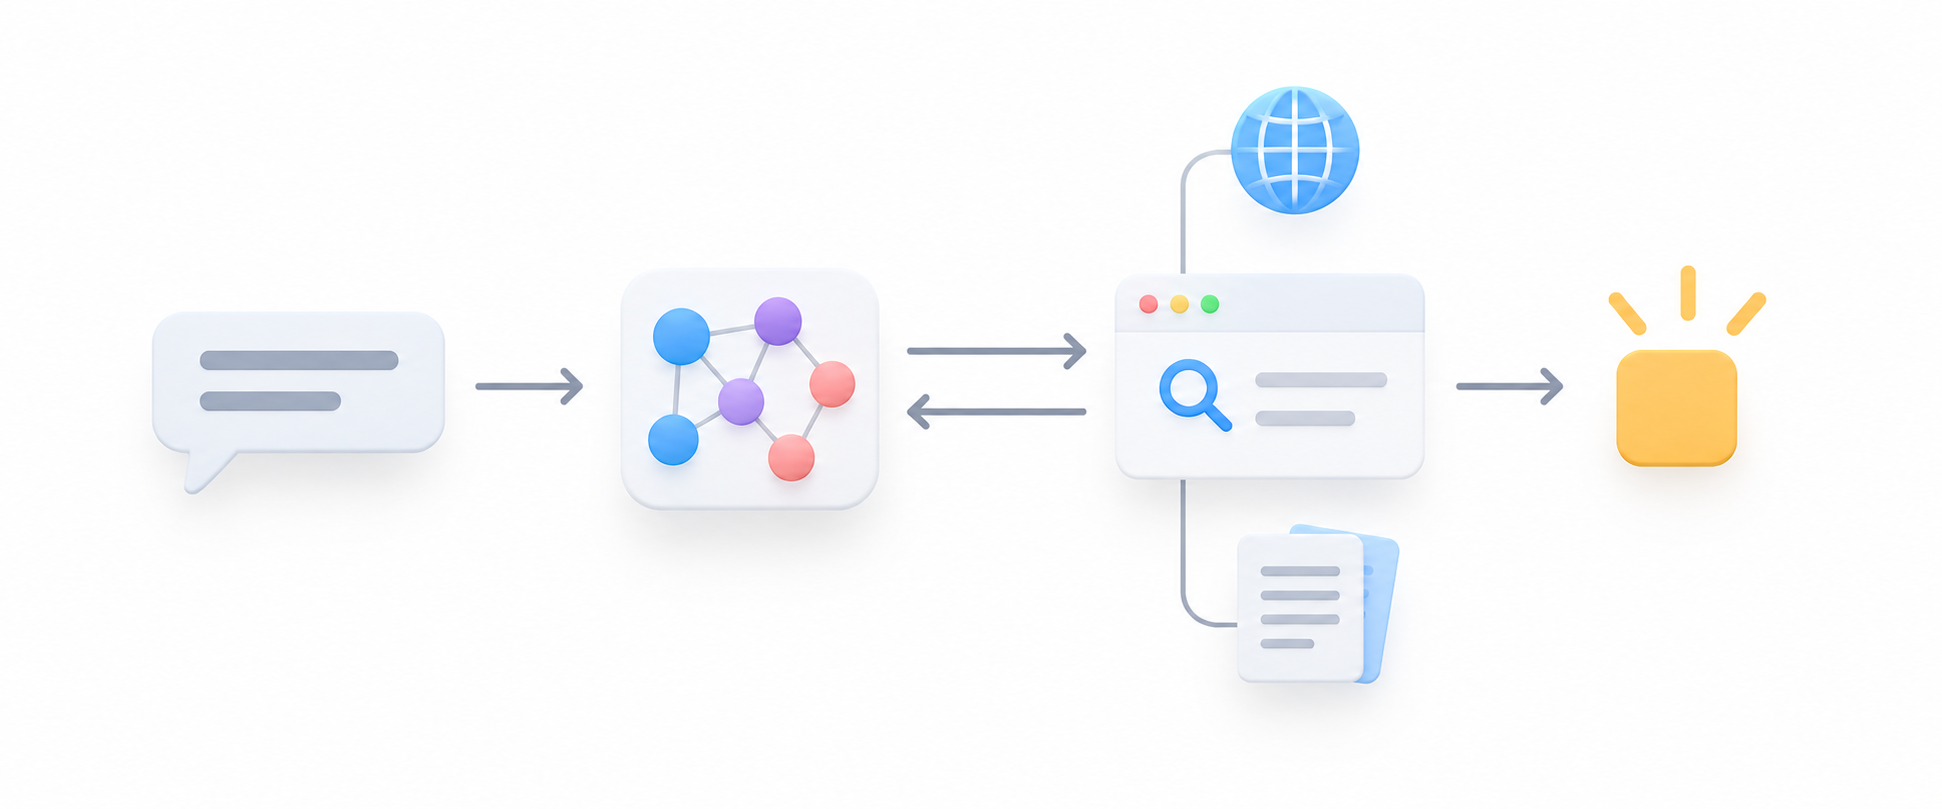
파라미터가 아무리 많고 추론 능력이 뛰어난 모델이라도 세상의 모든 정보를 담아둘 수는 없다. 특히 모델이 학습한 이후에 발생한 사건이나 실시간 정보는 파라미터와 추론만으로 알아낼 수 없다.
예를 들어 "오늘 코스피 지수는 얼마로 마감했어?" 같은 질문이 그렇다. 오늘의 종가는 학습 데이터에 존재하지 않는 정보이고 논리적 추론으로 유추할 수 있는 값도 아니다.
이럴 때 필요한 것이 웹 검색이다. 웹 검색 기능이 연결된 AI는 인터넷에서 필요한 정보를 찾아 답변에 활용한다. 최신 뉴스나 주가처럼 학습 당시에는 존재하지 않던 정보뿐 아니라, 모델이 정확히 기억하지 못하는 세부 정보도 외부 자료를 통해 보완할 수 있다.
정리하면 파라미터는 학습을 통해 익힌 패턴과 지식의 기반을 제공하고, 추론은 이미 알고 있는 정보에서 새로운 답을 도출하며, 웹 검색은 모델 내부에 없는 정보를 외부에서 가져온다. 즉, 우리가 사용하는 AI 답변은 학습하고 추론한 것에 새로 찾은 정보를 합쳐놓은 결과로 볼 수 있다.
'✏️ Topics' 카테고리의 다른 글
| 무료 인터넷 속도 측정 서비스가 돈을 버는 방법 (0) | 2026.07.05 |
|---|---|
| 애플 WWDC 2026에서 시리(Siri)가 조용했던 이유 (0) | 2026.06.16 |
| AI가 사람을 호출하기 시작했다 (0) | 2026.03.05 |
| 기술 봉건주의 Techno Feudalis (0) | 2024.06.11 |
| 포르노그래피(음란물)가 미국 기업과 가정에 미치는 영향 (0) | 2024.05.30 |